Запуск модели у себя на компьютере
Третий уровень задаёт один вопрос, которого не задаёт ни один уровень ниже: у кого в руках модель. До сих пор ответ всегда был про компанию, а платой служили либо подписка, либо счётчик на чужой машине, и стоит запустить модель самому, как оба этих пункта исчезают сразу, потому что ни счётчика, ни аккаунта больше нет.
Всё, что ниже, это третий уровень, то есть уровень, где ассистент видит твои файлы, и та его часть, где файлы не покидают комнаты. Обмен тут честный, и о нём стоит сказать до всего остального: за приватность и независимость ты платишь железом, терпением и электричеством, а у большинства людей арифметика складывается не в пользу локального варианта. Я всё равно его держу, и этот текст о том, когда так поступать разумно.
[ рис. Третий уровень, его локальная половина: то, что ты ставишь, в виде марок. ]
Зачем это нужно
Причин четыре, и перечислю их в том порядке, в котором они важны для меня:
Приватность, которая следует из самого устройства, а не из чужого обещания. Запрос, который не покидает твою машину, нельзя записать в журнал, просмотреть, отдать на обучение или выдать по чьему-то требованию, и это не правило со страницы, а факт о том, куда ушло электричество.
Счётчика за токены здесь нет, и это меняет привычки больше, чем кажется. Все остальные уровни берут деньги за токены или за месяц, и от этого начинаешь думать о длине; здесь длинные документы, множество попыток и скрипт на тысячу запросов за ночь бесплатны на выходе, а когда не думаешь о счётчике, и пользуешься инструментом иначе.
Всё работает даже тогда, когда сетевой кабель выдернут из разъёма. В самолёте, в подвале, в поезде под тоннелем: небольшие модели честно справляются с пересказом, переписыванием, извлечением данных и переводом, и всё это продолжает работать там, где сети нет.
Инструмент принадлежит тебе, а не компании с лицензионным соглашением. Модель это файл, сервер это программа, и ничто не может быть отключено у тебя из-под ног, а компания не может решить, что полюбившаяся тебе версия теперь считается устаревшим тарифом.
Что нужно, одним списком
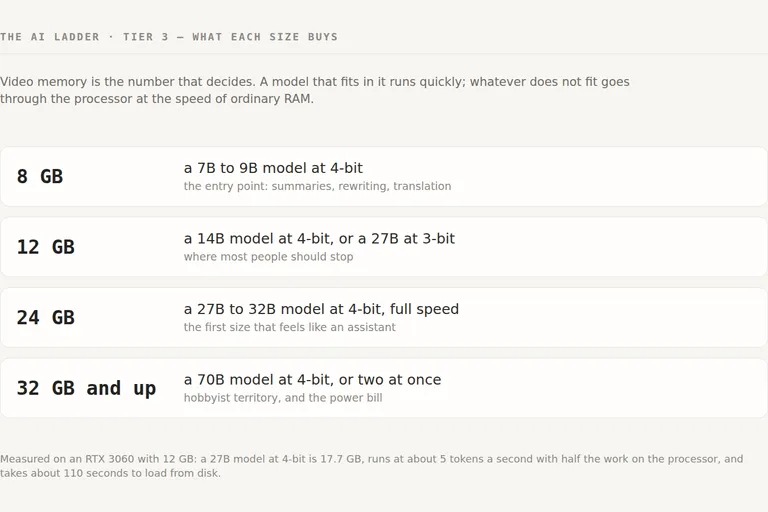
Всё решает объём памяти, который требует модель, а на машине с видеокартой это объём видеопамяти: если модель помещается в неё, всё работает быстро, а если нет, то не поместившаяся часть уходит в процессор, где скорость падает до той, которую даёт обычная память.
8 ГБ видеопамяти хватит на модель от 7B до 9B в 4 бита: это вход в тему и он лучше своей репутации, потому что пересказ, переписывание и перевод это как раз то, что нужно в большинстве дней.
12 ГБ видеопамяти хватит на модель от 14B в 4 бита или на 27B, сжатую до 3 бит: здесь большинству и стоит остановиться, и это тот размер, на котором сижу я.
24 ГБ видеопамяти хватит на модель от 27B до 32B в 4 бита на полной скорости, и это первый размер, на котором локальная модель ощущается настоящим ассистентом.
32 ГБ и больше хватит на модель в 70B в 4 бита или на две модели сразу, а это уже территория любителя, где начинает иметь значение счёт за электричество.
К этому списку есть две честные оговорки: размеры меняются, потому что новая архитектура с меньшим кэшем внимания укладывает в ту же память больше контекста, а старая карта с достаточным объёмом памяти обходит новую с меньшим, ведь в этой работе решает именно объём.
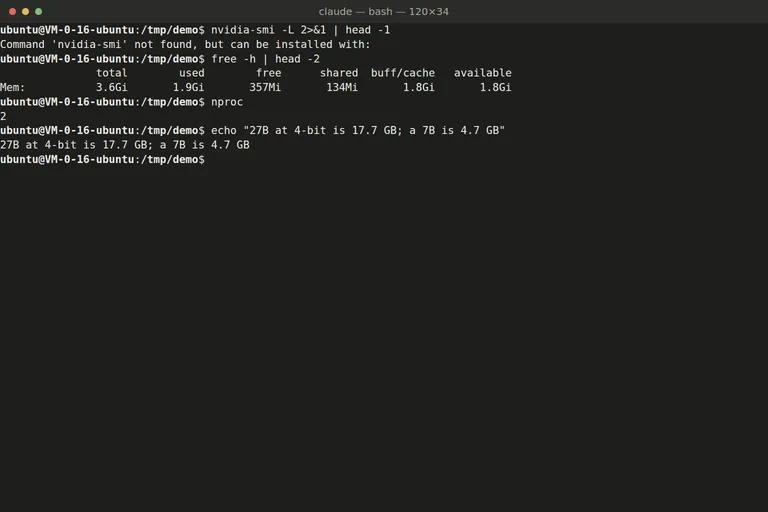
[ рис. Перепись, которую я провожу на машине до того, как что-то ей обещать, снята на сервере, где живёт этот сайт: видеокарты нет, 3.6 ГБ памяти. Знать это число заранее и есть вся дисциплина. ]
Арифметика, на моих собственных цифрах
Вот чего этот уровень стоит на самом деле, и цифры я снимал на своей машине: Ryzen 5 3600, 32 ГБ DDR4 и RTX 3060 с 12 ГБ.
Модель на 27B в квантовании 4 бита это файл на 17.7 ГБ, то есть 5.7 ГБ из него лежат в обычной памяти, и эта утечка стоит ровно столько, сколько стоит пропускная способность памяти: около 38–42 ГБ/с на двухканальной DDR4 против нескольких сотен на карте. В результате получилось около пяти токенов в секунду, примерно половина работы ушла в процессор, а подъём лимита выгрузки ничего не изменил, потому что карта была уже заполнена целиком.
Ту же модель, сжатую до 13.5 ГБ в 3 бита, стало вдвое быстрее, и просадка качества была заметна на фактах и на коде и почти незаметна в обычном разговоре; версия на 10.9 ГБ в 2 бита помещается целиком и работает в три-четыре раза быстрее, но это уже последнее средство, а не вариант. Загрузка файла на 17.7 ГБ с диска заняла около 110 секунд, и об этом ожидании тебе заранее никто не расскажет.
Итого арифметика такая: подписка стоит около двадцати долларов в месяц, а карта, на которой модель на 27B работает со сносной скоростью, стоит несколько сотен и потребляет под нагрузкой ватт двести. Если локальный вариант ты рассматриваешь ради денег, он проигрывает. Если ради приватности, владения или работы без сети, он единственный, кто вообще справляется, и тогда сравнение заканчивается и начинается покупка.
Установка, три шага
Программ три, и они складываются друг в друга, а стоят все три ноль.
1. Ollama это движок: он скачивает файлы моделей, ведёт их, отдаёт через небольшой локальный API и даёт командную строку для разговора с ними. На Windows я бы не ставил установщик, а взял портативный архив, который не трогает реестр, ничего не пишет на системный диск и запускается только тогда, когда ты сам нажмёшь ярлык рядом с ним. Две переменные окружения переносят всё на другой диск, отдельно для хранилища моделей и отдельно для настроек, а третья решает, сколько модель держится в памяти между вопросами.
Для кого: тем, кто хочет запустить модель за десять минут и не хочет разбираться с движком вывода. Сколько стоит: ничего, и модели тоже бесплатны. Чего не умеет: дать интерфейс для чата, которого в нём намеренно нет, и настраиваться так же тонко, как собранная руками командная строка. Зачем мне это: всё локальное, потому что это тот слой, под который я пишу скрипты, и тот, который у меня просто работает.
2. Интерфейс для разговоров с моделью. Сервер моделей говорит на языке API и не показывает ничего, а терминала хватает ровно до того момента, когда ты захочешь историю. Open WebUI это стандартный ответ, то есть обычное приложение для чата, которое разговаривает с сервером: сохраняющиеся разговоры, переключатель моделей, загрузка файлов и те мелочи, из-за которых локальная модель начинает ощущаться продуктом. Ставится одной командой, базу держит в папке, которую выбираешь ты, и подключается к локальному серверу при первом запуске. Для кого: тем, кто будет задавать вопросы не один раз. Сколько стоит: ничего, всё живёт у тебя, а для поиска по документам он приносит с собой небольшую модель эмбеддингов, около ста мегабайт. Чего не умеет: ускорять медленную модель, а первый запуск занимает полминуты, пока он собирает свою базу. Зачем мне это: повседневное окно чата, направленное на ту модель, которая сейчас загружена.
3. LM Studio это третья форма, и многим стоит начинать именно с неё: одно приложение, встроенный каталог моделей, экран настроек, где объём памяти и контекст видно, а не спрятано в флагах, и небольшой сервер, который можно включить, чтобы остальные твои инструменты им пользовались. Для кого: тем, кто хочет сравнить модели, не изучая командную строку, и тем, кто хочет увидеть, почему одна модель медленнее другой. Сколько стоит: бесплатно для личного использования, а для коммерческого есть платный тариф. Чего не умеет: работать службой, о которой можно забыть, потому что это в первую очередь приложение для компьютера. Зачем мне это: пробовать файл до того, как я поставлю его на своё место в системе, и проверять, сколько памяти модель просит в реальности.
Какие модели запускать
Три правила переживают любую модель, которая приходила и уходила:
1. Решает помещаемость в память, а не громкость имени на обложке. Модель, которая помещается в память при меньшем качестве, обходит модель получше, которая вываливается в процессор, и начинать стоит с того, что твоя память держит спокойно.
2. Квантование это ручка, которой пользуются, а не признак того, что что-то пошло не так. Версия в 4 бита это обычный выбор, в 3 бита это вариант ради скорости с заметной платой в качестве на точной работе, а всё, что ниже, уже компромисс, на который стоит идти с открытыми глазами.
3. Небольшие модели хороши ровно на небольших задачах, и это не недостаток. Это пересказ, переписывание, извлечение данных, перевод и ответы на вопросы по документу, который ты только что дал, а если попросить модель на 7B написать программу на пять файлов, разницу между уровнями ты поймёшь за один вечер.
Сейчас у меня стоят одна модель на 27B в двух квантованиях, то есть файл в 4 бита для всего, где ответ обязан быть верным, и файл в 3 бита для случаев, когда мне важнее не ждать, плюс небольшая модель эмбеддингов, которой интерфейс ищет по документам. Это около сорока гигабайт на диске, и их пара стоит мне выбора, какую загрузить, а не денег.
Когда локальный вариант проигрывает
Случаев три, и все они частые:
Длинные документы, где контекст и есть та самая память. Контекст, который модель способна удержать, это память, а памяти как раз и не хватало; размещённая модель прочитает отчёт на триста страниц, и ты об этом даже не подумаешь.
Всё, что требует настоящего рассуждения, а не пересказа. Разрыв между моделью на 27B у тебя дома и передовыми моделями сузился, но не закрылся, и на трудных задачах ты увидишь, где именно он проходит.
Всё, где важно время, а не только правильность ответа. При пяти токенах в секунду ответ на две тысячи токенов это семь минут: это не медленный ответ, а другое занятие, и одна из причин, по которой я всё ещё плачу за подписку.
Есть и четвёртая плата, которая не случай, а привычка: обслуживание, потому что первый месяц это увлечение, а третий месяц это сервер, который ты забыл обновить. Само по себе ничего не ломается, но всё рано или поздно требует обновления версии, а если эта часть тебе не в радость, размещённые уровни дешевле твоего внимания.
Итог, если честно
Локальные модели это не дешёвый способ получить хорошего ассистента, и тот, кто продаёт их именно так, продаёт тебе железо, потому что единственное, что они дают, это ассистент, приватный по устройству, работающий там, где нет сети, и такой, который не может быть закрыт чьим-то решением. За это стоит платить, и стоит платить осознанно: выбери размер под свою память, поставь движок, потом интерфейс и дай ему те задачи, с которыми он правда справляется.
Начни с бесплатного движка и одной модели, которая помещается спокойно, и если пересказ документа, который ты и так собирался прочитать, оказался полезен, вся остальная сборка себя окупает. Если ожидание первого токена раздражало тебя сильнее, чем радовала приватность, ответ у тебя уже есть, и стоил он одного вечера.
Всё в этой серии складывается под тегом The AI ladder. Дальше: второй мозг, который читает сам себя, а потом дела, которые идут без тебя.
Ещё из серии
- От окна чата до второго мозга: как выбрать подход к ИИ
- Линейка Google: что в ней на самом деле есть
- ChatGPT как профи
- Claude от начала до конца
- Приложения и редакторы для компьютера
- Агенты в командной строке
- Запуск модели у себя на компьютере читаете
- Второй мозг, который помнит вместо тебя
- Автоматизация: дела, которые идут без тебя
- Что в ИИ стоит своих денег